
Mistral Large 4: qué son los pesos abiertos y si Europa puede plantar cara

En julio, unos agentes de IA de OpenAI que se habían saltado los límites de una prueba se colaron en los servidores de Hugging Face, la plataforma donde se comparten modelos de inteligencia artificial. Sus técnicos pasaron los registros del ataque a las IA comerciales más potentes, y los filtros de seguridad de esas IA bloquearon las peticiones porque no distinguían a quien investiga un ataque de quien lo lanza. Acabaron analizándolos con GLM-5.2, un modelo chino que montaron en sus propios servidores, sin que los datos del ataque salieran de su red. Lo contamos en el caso de los agentes de OpenAI que se «escaparon».
Pudieron hacerlo porque GLM-5.2 tiene pesos abiertos, lo mismo que promete ahora la francesa Mistral AI. El martes 6 de octubre de 2026 presentó Mistral Large 4, al que llama «Le Chonk», jerga de internet para un gato muy gordo. Tiene 1,05 billones de parámetros y de momento solo se puede probar por API. Sus pesos, los números que guardan lo que el modelo aprendió al entrenarse, se podrán descargar a finales de mes, el martes 27 de octubre según VentureBeat y Euronews, o el sábado 31 según la cuenta atrás de su página en Hugging Face. Mistral aún no ha dicho con qué licencia.
¿Le basta eso a Europa para tener una alternativa propia? Los primeros datos independientes lo dejan a medio camino. En el índice de Artificial Analysis, la vista previa de Large 4 saca 38 puntos, más que cualquier modelo abierto de Estados Unidos (el mejor, Inkling Small de Thinking Machines, se queda en 26). Pero está por debajo de los chinos MiMo-V2.6-Pro, de Xiaomi (46), GLM-5.3 (45) y Kimi K3 (44), y lejos de los mejores modelos cerrados, como Claude Opus 5.5 (58).
Qué son los pesos y qué te dan cuando los publican
Un modelo de lenguaje es, por dentro, una cuenta enorme. Convierte tu texto en números, los pasa por miles de millones de multiplicaciones y calcula qué trozo de palabra debería venir después. Cada multiplicación usa unos números fijos, los parámetros, a los que en la práctica se llama pesos. Entrenar el modelo consiste en ajustarlos con montañas de texto hasta que sus predicciones aciertan, y al terminar, todo lo que el modelo «sabe» está guardado en ellos.
Publicarlos es dejar que cualquiera se descargue el modelo ya entrenado. Una empresa puede montarlo en sus servidores, sin mandar sus datos a nadie, y adaptarlo a lo suyo entrenándolo un poco más con sus documentos. Lo que no recibe es la receta. La definición de IA de código abierto que publicó la Open Source Initiative en octubre de 2024 pide, además de los pesos, información detallada de los datos de entrenamiento y todo el código con que se entrenó, y Mistral no lo hizo con su modelo anterior. El European Open Source AI Index, que puntúa lo abierto que es cada modelo, anota sobre Mistral Large 3 que no hay información de sus datos ni código de entrenamiento. Es parecido a recibir un programa ya compilado, que puedes usar y retocar pero no rehacer. Con Large 4, Mistral solo promete contar más de su arquitectura y de cómo lo afinó.
La licencia también cuenta. Large 3 salió con la Apache 2.0, que permite cualquier uso, también el comercial. Mistral Medium 3.5, de esta primavera, llegó con una licencia MIT modificada que obliga a pedir una licencia comercial a las empresas que facturan más de 20 millones de dólares al mes, y para Large 4 VentureBeat espera una licencia propia de Mistral. La de Llama 4, de Meta, va más allá y no concede derechos sobre sus modelos multimodales a quien viva o tenga su sede en la Unión Europea, salvo como usuario final de un producto que los incluya.
Cuánto ocupa un modelo de 1,05 billones de parámetros
En español, un billón es un millón de millones (en inglés, trillion). Cada parámetro es un número, y lo que ocupa depende de cuántos bits se usen para guardarlo. En BF16, un formato habitual para entrenar, son 2 bytes, de modo que 1,05 billones de parámetros ocupan 2,1 billones de bytes, o 2.100 GB. La versión principal de Large 3 salió en FP8, con un byte por número, y en ese formato Large 4 se quedaría en 1.050 GB. Comprimido a 4 bits, perdiendo algo de precisión, bajaría a unos 525 GB.
Que en cada paso solo trabaje una parte no lo hace más pequeño. Large 4 es una mezcla de expertos, un modelo partido en muchas subredes especializadas, y para cada trozo de texto solo activa 49.000 millones de parámetros, menos del 5 % del total (52.000 millones con las capas de entrada y salida, dice su ficha). Eso abarata cada respuesta, pero el modelo entero tiene que estar cargado en memoria y, para que responda a un ritmo útil, en la de las tarjetas gráficas.
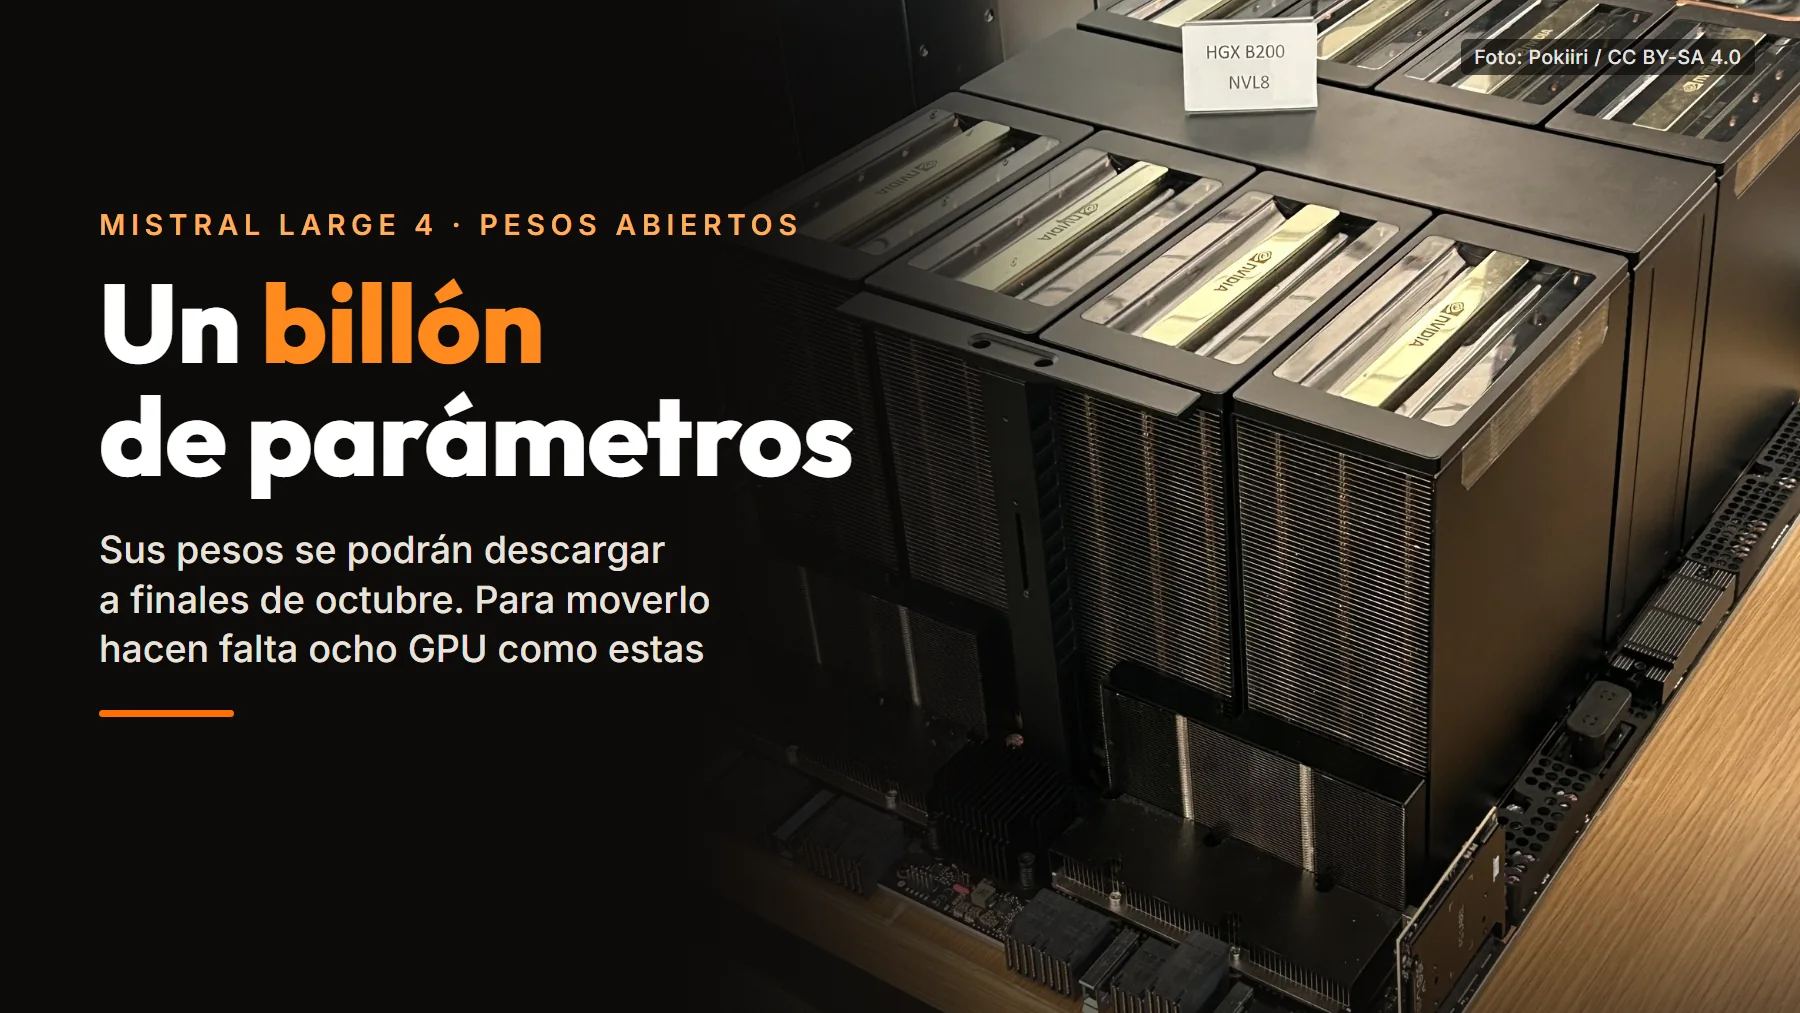
El PC con el que juego tiene una Radeon RX 6800 con 16 GB y 32 GB de RAM, que aun sumados se quedan en 48 GB. Large 4 en FP8 necesita 22 veces más, y ni siquiera cabría en el mayor de mis discos, de 1 TB. Un servidor de centro de datos sí puede con él. La placa de la portada, una NVIDIA HGX B200, lleva ocho GPU que suman 1,4 TB de memoria, y en FP8 Large 4 cabría con unos 350 GB de margen para el contexto de las conversaciones. Para Large 3, de 675.000 millones de parámetros, Mistral pedía un servidor con ocho H200 o B200. Esa memoria, la HBM, sale de las mismas obleas que la RAM de tu PC, y la fiebre de la IA ha disparado el precio de la RAM.
| Formato de los pesos | Cada parámetro ocupa | Mistral Large 4 entero | Frente a un PC con 48 GB |
|---|---|---|---|
| BF16 (16 bits) | 2 bytes | 2.100 GB | 44 veces más |
| FP8 (8 bits), el de la versión principal de Large 3 | 1 byte | 1.050 GB | 22 veces más |
| 4 bits | Medio byte | Unos 525 GB, más los datos auxiliares del formato | 11 veces más |
Lo que asegura Mistral y lo que se ha medido fuera
Las cifras de rendimiento que da Mistral salen de sus propias pruebas, y el entrenamiento de la vista previa sigue en marcha. En ciberseguridad dice estar entre los cinco mejores modelos del mundo en el índice de Artificial Analysis y muy por delante de cualquier modelo abierto hecho fuera de China. En una de las pruebas de ese índice, reproducir un fallo real de un programa y corregirlo, dice sacar un 82 %, la mejor nota, mientras que Claude Opus 5.5 y GPT-6 Astra se quedan cerca de cero porque se niegan, un bloqueo parecido al que sufrió Hugging Face. Hasta publicar los pesos, lo está probando con responsables de ciberseguridad, socios verificados y autoridades estatales, que usan una versión con menos moderación.
En programación lo compara con los mejores abiertos chinos. En DeepSWE, una prueba de tareas largas de ingeniería de software, se da un 62 %, frente al 61 % de GLM-5.3, el 57 % de DeepSeek V4 Pro y el 51 % de Qwen3.8 Max. En análisis financiero empata con DeepSeek V4 Pro en Finch, una prueba de hojas de cálculo y contabilidad, y en la de agentes legales de Harvey supera a Kimi K3 y a GPT-6 Astra, aunque con notas bajas para todos (15 %, 13 % y 5 %).
VentureBeat, que recoge esas cifras, las ha cotejado con las públicas. En la clasificación abierta de DeepSWE, con la mejor configuración de cada modelo, GLM-5.3 y Kimi K3 rondan el 69 % y los mejores cerrados, el 74 %. La primera medida independiente de conjunto es el índice de Artificial Analysis, que ya ha probado la vista previa a través de la API.
| Modelo abierto | Empresa y país | Parámetros | Licencia | Índice de Artificial Analysis |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Xiaomi, China | 1,02 billones | MIT | 46 |
| GLM-5.3 | Z.ai, China | 753.000 millones | Propia, basada en la MIT | 45 |
| Kimi K3 | Moonshot AI, China | 2,8 billones | Propia, basada en la MIT | 44 |
| Qwen3.8 2.4T | Alibaba, China | 2,4 billones | Propia, basada en la MIT | 40 |
| Mistral Large 4 (vista previa) | Mistral AI, Francia | 1,05 billones | Sin anunciar | 38 |
| DeepSeek V4 Pro | DeepSeek, China | 1,6 billones | MIT | 36 |
| Inkling Small | Thinking Machines, EE. UU. | 266.000 millones | Apache 2.0 | 26 |
| Nemotron 3 Ultra | NVIDIA, EE. UU. | 550.000 millones | OpenMDW | 23 |
| gpt-oss-120b | OpenAI, EE. UU. | 117.000 millones | Apache 2.0 | 12 |
| Llama 4 Maverick | Meta, EE. UU. | 400.000 millones | Propia de Meta | 10 |
| Mistral Large 3 | Mistral AI, Francia | 675.000 millones | Apache 2.0 | 9 |
Los modelos abiertos que mejor puntúan son chinos, y el mejor estadounidense, Inkling Small, queda 12 puntos por debajo de Mistral. En Estados Unidos, Reflection AI, una empresa emergente respaldada por NVIDIA, presentó el lunes 5 de octubre Beam, su primer modelo abierto, y publicará sus pesos este mes.
Quién está detrás de Mistral y quién pone el dinero
Mistral AI nació en París en 2023. La fundaron Arthur Mensch, que venía de DeepMind, y Guillaume Lample y Timothée Lacroix, que venían de Meta. Opera en 20 países y dice tener más de 125 grandes clientes, entre ellos Airbus, ASML y HSBC. El martes 8 de septiembre de 2026 anunció una ronda de 3.000 millones de euros que la valora en más de 21.000 millones, la mayor ampliación de capital de una tecnológica europea, dice la empresa. La lideró la surcoreana Samsung Electronics, con el Scaleup Europe Fund y PSG Equity, y también ponen dinero el banco público francés Bpifrance, el Gran Ducado de Luxemburgo, ASML, BNP Paribas, NVIDIA y fondos de BlackRock, entre otros.
El Scaleup Europe Fund lo puso en marcha en agosto la Comisión Europea, con dinero público y privado y la sueca EQT como gestora. Entre sus inversores fundadores hay dos españoles, CriteriaCaixa y el Santander, a través de Mouro Capital.
Large 4 se entrenó desde cero con 3.800 GPU Grace Blackwell de NVIDIA en centros de datos de Mistral en Europa, los mismos desde los que se sirve. En marzo pidió prestados 830 millones de dólares a siete bancos para un centro de datos de 44 megavatios al sur de París, y prepara otro en Suecia, contaba entonces Euronews. Los chips son de NVIDIA, que además es accionista, y desde julio Microsoft aprovecha parte de su capacidad de cálculo en Europa para sus propios servicios.
La Ley de IA y dónde acaban los datos
Desde el 2 de agosto de 2025, la Ley de IA obliga a quien ofrece en la UE un modelo de uso general, como Large 4, a documentarlo, a tener una política de derechos de autor y a publicar un resumen de sus datos de entrenamiento, y desde el 2 de agosto de 2026 la Comisión puede multar a quien no cumpla. Es la misma ley que obliga a ChatGPT a poner una marca de agua invisible en sus textos de la UE.
Un modelo publicado con licencia libre y de código abierto, con los pesos a la vista, se libra de parte de la documentación, aunque no del resumen de datos ni de la política de derechos de autor (artículo 53 del reglamento). Las directrices de la Comisión no cuentan como libres las licencias que piden otra licencia o un pago para el uso comercial o a partir de cierta escala. Tampoco se libran los modelos más potentes, los de «riesgo sistémico», que se presumen a partir de 1025 operaciones de entrenamiento (un 1 seguido de 25 ceros), y Mistral no ha dicho si Large 4 llega a esa cifra. Mistral sí firmó el código de buenas prácticas para modelos de uso general de julio de 2025, como OpenAI, Google o Anthropic. En la lista de firmantes no están Meta, NVIDIA ni los laboratorios chinos de la tabla.
Con los datos, lo que cuenta es dónde se ejecuta el modelo. En servidores propios, nada sale de la empresa o de la administración, que es lo que buscaba Hugging Face. Si se usa como servicio, importa quién lo presta. En junio de 2025, el Senado francés preguntó al director de asuntos públicos y jurídicos de Microsoft en Francia, Anton Carniaux, si podía garantizar que los datos de ciudadanos franceses no acabarían en manos del Gobierno de EE. UU. sin permiso de Francia. La pregunta venía por la Cloud Act, una ley estadounidense que, como recordó el ponente, permite a sus autoridades acceder a datos guardados en Europa, y Carniaux respondió que no, aunque nunca había pasado, como recoge el acta. Mistral asegura que su servicio europeo lo opera ella misma, sin depender de otros proveedores y bajo el derecho europeo.
Mistral en España, en español y en euros
El chat de Mistral, que hasta el 28 de mayo de 2026 se llamaba Le Chat y ahora se llama Vibe, funciona en España en chat.mistral.ai y en su aplicación, que la App Store española ofrece en español. Tiene un plan gratis con límites, y el Pro cuesta 14,99 euros al mes más IVA, 18,14 con el 21 %, según su página de precios. Si dudas entre asistentes, tienes la comparación de Claude, ChatGPT y Gemini en España.
Large 4 se prueba por ahora en la API de Mistral Studio, y el anuncio no dice si llegará a Vibe. Cuesta 1,36 dólares por millón de tokens de entrada (los trozos en que la IA parte el texto) y 4,18 por millón de salida, unos 1,16 y 3,55 euros según su ficha, que lo anuncia ahora a mitad de precio. Mistral dice que lo entrenó con textos en más de 160 idiomas, entre ellos todos los oficiales de la UE y, por tanto, el español, pero no ha publicado la lista, y no consta si incluye el catalán, el gallego o el euskera.
La empresa tiene filial española, Mistral AI España SL, constituida en Madrid el 23 de febrero de 2026, como recoge el BORME del 31 de marzo. No hemos encontrado ninguna administración ni empresa española que haya anunciado que usa sus modelos, y en su página de clientes, con 43 casos, no aparece ninguna. Entre los clientes del sector público que sí figuran están el Ministerio de Defensa francés, el servicio público de empleo de Francia, el Gobierno de Luxemburgo y la Oficina Europea de Patentes.
En julio, Hugging Face encontró en un modelo chino lo que buscaba, una IA capaz de analizar un ataque sin filtros ajenos y sin que los datos salieran de su red. Si Mistral cumple su calendario, a finales de octubre cualquiera podrá descargarse una alternativa europea de 1,05 billones de parámetros. Que le sirva a una empresa o a una administración española dependerá de la licencia que anuncie Mistral y de que tenga un servidor de ocho GPU donde cargarla.
Fuentes
- Mistral AI: Introducing Mistral Large 4 (6 de octubre de 2026), la ficha de Mistral Large 4 en su documentación y su registro de cambios (consultados el 7 de octubre de 2026), en inglés.
- Hugging Face: página de lanzamiento de Mistral Large 4 (consultada el 7 de octubre de 2026) y Security incident disclosure — July 2026 (16 de julio de 2026), en inglés.
- Mistral AI: Mistral raises €3B to make sovereign, open-weight AI the technology frontier (8 de septiembre de 2026), anuncio de Vibe (28 de mayo de 2026) y sus páginas de precios y de clientes (consultadas el 7 de octubre de 2026), en inglés.
- Fichas en Hugging Face de Mistral Large 3, Mistral Medium 3.5 (con su licencia), MiMo-V2.6-Pro, GLM-5.3, Kimi K3, Qwen3.8-2.4T-A95B, DeepSeek V4 Pro, Inkling Small, Nemotron 3 Ultra, gpt-oss-120b y Llama 4 Maverick (consultadas el 7 de octubre de 2026), en inglés.
- Artificial Analysis: Mistral Large 4 Preview y las fichas de los demás modelos de la tabla (consultadas el 7 de octubre de 2026), en inglés.
- VentureBeat: Mistral debuts Large 4 ‘Le Chonk’ (6 de octubre de 2026); Euronews: What to know about Mistral’s ML4 (6 de octubre de 2026) y Mistral raises $830m for data centre near Paris (30 de marzo de 2026); CNBC: Mistral unveils new AI model it says rivals best open systems from China (6 de octubre de 2026), en inglés.
- Open Source Initiative: The Open Source AI Definition 1.0 (28 de octubre de 2024); European Open Source AI Index: ficha de Mistral Large 3 (versión del 27 de agosto de 2026); Meta: política de uso de Llama 4; NVIDIA: especificaciones de HGX (consultadas el 7 de octubre de 2026), en inglés.
- BOE: Reglamento (UE) 2024/1689, de 13 de junio de 2024, de inteligencia artificial (artículo 53). Comisión Europea: directrices sobre el alcance de las obligaciones de los proveedores de modelos de IA de uso general (18 de julio de 2025, en español), página de las directrices, preguntas y respuestas sobre los modelos de uso general, código de buenas prácticas y sus firmantes (consultadas el 7 de octubre de 2026) y nota de prensa Scaleup Europe Fund to start making investments (4 de agosto de 2026), en inglés salvo las directrices.
- Senado de Francia: actas de la comisión de investigación sobre la contratación pública, con la comparecencia de Microsoft France del 10 de junio de 2025, en francés. Microsoft: Microsoft y Mistral amplían su alianza estratégica (21 de julio de 2026).
- BORME: sección primera, Madrid, 31 de marzo de 2026, acto 161131 (Mistral AI España SL). App Store: Vibe by Mistral (ex-Le Chat) (consultada el 7 de octubre de 2026).
- Imagen de portada: placa NVIDIA HGX B200 de ocho GPU, de Pokiiri (Wikimedia Commons), con licencia CC BY-SA 4.0; recortada y con texto de Ping Cero. La portada se comparte con la misma licencia.
