
Cómo saber si un texto lo ha escrito una IA y por qué sus muletillas no bastan

Abres el correo de un compañero y algo chirría. Está bien escrito y sin una falta, pero cada párrafo te recuerda por qué el asunto es importante, todo es «más que un simple trámite» y al final llega un resumen que nadie había pedido. Puede que te haya pasado también con un trabajo de clase o con una reseña demasiado redonda. ¿Lo ha escrito una persona?
El 1 de octubre de 2026, la agencia de marketing Graphite publicó una respuesta con números al poner al día un estudio del 16 de septiembre que compara casi 10.000 artículos humanos con los que escriben, sobre los mismos temas, modelos de Anthropic, OpenAI y Google. Cada modelo tiene sus muletillas, aunque ninguna sirve para acusar a nadie.
Cómo se cazan las muletillas de una IA
Graphite tomó 10.000 artículos de Common Crawl, un archivo público de páginas web, publicados antes del 30 de noviembre de 2022, cuando llegó ChatGPT. Por la fecha, es muy probable que los escribieran personas. Un modelo de OpenAI resumió cada uno y, con ese resumen, cada IA escribió su versión, con la misma longitud e instrucciones.
Luego contó. Llama tell («lo que te delata») a toda palabra, expresión o molde de frase que una IA usa al menos el doble que las personas, y compara 9.974 temas con un texto humano y uno de cada uno de los diez modelos. Ten en cuenta que Graphite es una empresa, que su trabajo no lo han revisado otros científicos antes de publicarse y que todo está en inglés.
Las muletillas de Claude, GPT y Gemini
La actualización del 1 de octubre añade Claude Opus 5.5, que Anthropic lanzó el 22 de septiembre, y lo pone junto a GPT-6 Astra, de OpenAI, y Gemini 3.1 Pro, de Google:
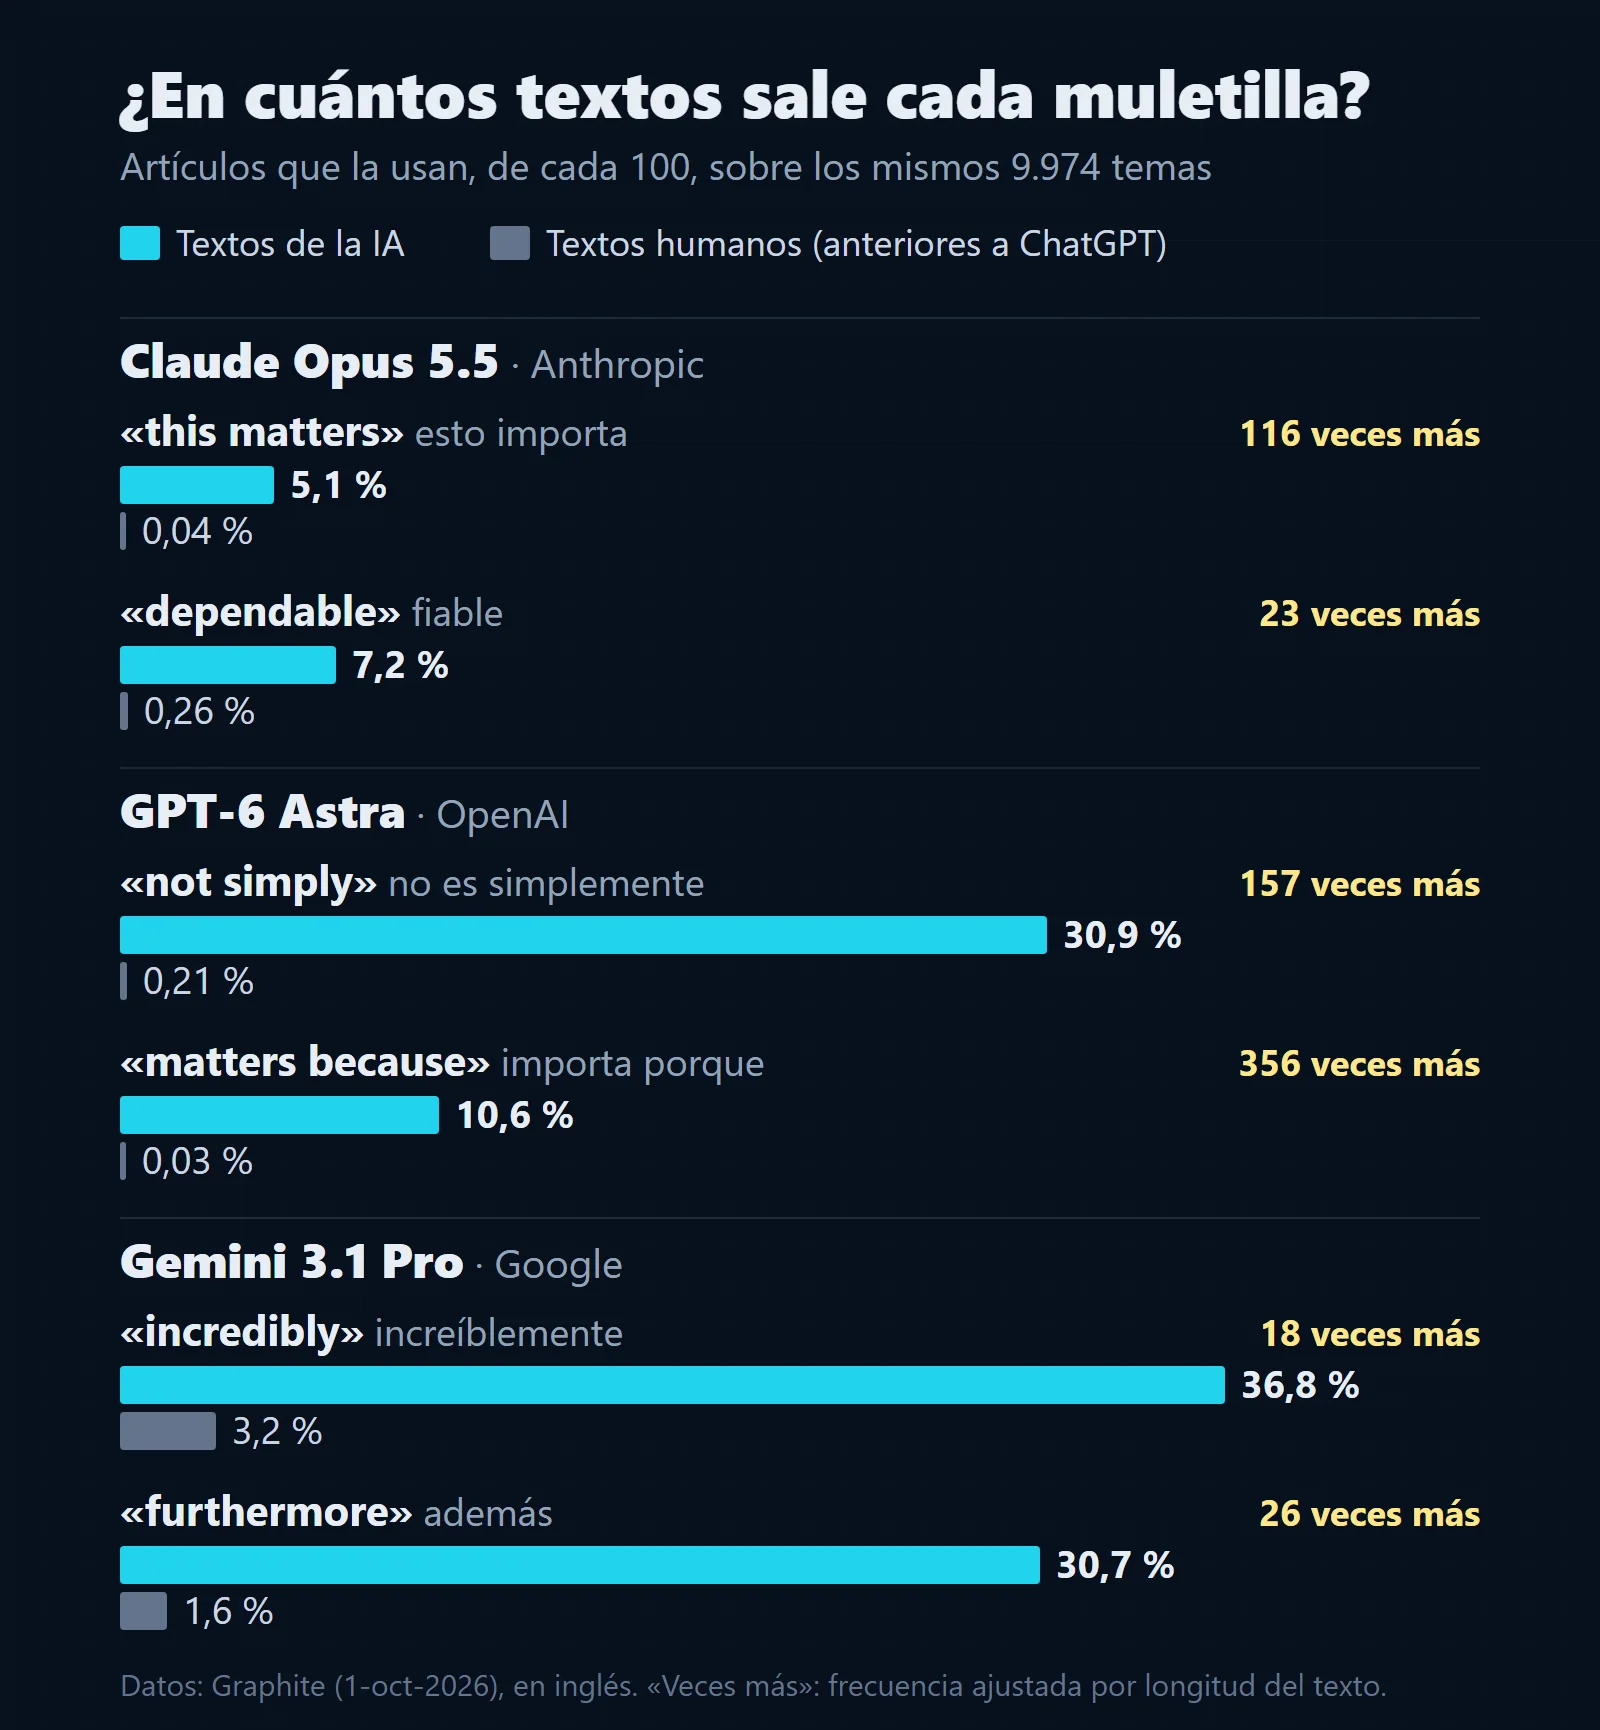
- Claude Opus 5.5 te recuerda que algo es importante. «This matters» («esto importa») le sale 116 veces más que a una persona, y «why… matters» («por qué importa…»), 92. Abusa de adjetivos que juzgan en vez de describir, como dependable («fiable», 23 veces más). Usa el «no es X, es Y» algo menos que las personas, pero recurre 98 veces más a un primo suyo: «es más que un X, es…». Tira más de superlativos que GPT, como «the most powerful» («el más potente»), que le sale 24 veces más que a Astra.
- GPT-6 Astra define las cosas por lo que no son. «Not simply» («no es simplemente») aparece 157 veces más que en un texto humano, y «rather than relying» («en lugar de depender»), 187. Matiza mucho más que Claude: «may provide» («puede aportar») le sale 18 veces más que a Opus 5.5. También subraya la importancia, con un «matters because» («importa porque») que multiplica por 356 la frecuencia humana, más del doble que en Claude.
- Gemini 3.1 Pro escribe como una guía de internet. Abusa de intensificadores como incredibly («increíblemente», 18 veces más), de conectores formales como furthermore («además», 26) y de fórmulas como «this comprehensive guide» («esta guía completa»), 435 veces más. Su «no es solo un X, es un Y» sale 155 veces más.
El estudio no incluye los modelos más nuevos, como GPT-6.1 Sol y Gemini 4 Argon, presentados el 29 y el 30 de septiembre (cuál puedes usar en España, en nuestro repaso de Claude, ChatGPT y Gemini).
Ojo al leer las cifras. «This matters» aparece en 512 de los 9.974 artículos de Opus 5.5 y en solo 4 de los humanos. O sea, 19 de cada 20 textos de Claude no la llevan. Pasa con todas.
Graphite cuenta 2.548 muletillas en Opus 5.5, solo un 4 % menos que en Opus 5. En «prosa amanerada» (florituras donde bastaba decirlo claro), Opus 5.5 saca 1,6 veces la nota humana, Astra 1,2 y Gemini 3.1 Pro 2,6 (dato del estudio de septiembre), aunque esa nota la pone Claude Opus 5 y Graphite admite posible sesgo. En el uso general de palabras, Opus 5.5 se acerca a la escritura humana, y Astra y Gemini se alejan respecto a sus versiones anteriores.
La raya ya no delata a nadie
La pista más famosa era la raya larga (—), el em dash del inglés, pero Opus 5.5 ya la usa un 99 % menos que Opus 5, Astra una octava parte que las personas y Gemini 3.1 Pro casi nunca. En español vale aún menos, porque la RAE la recoge para incisos y diálogos.
¿Qué delata a una persona? Según Graphite, la primera persona, las anécdotas y los recuerdos propios («hace años», «mi madre»), las coletillas («más o menos») y los paréntesis, mucho más habituales en los textos humanos. Las exclamaciones, en cambio, casi no aparecen en los tres modelos. Las frases humanas cambian mucho más de longitud, con más del doble de variación.
¿Por qué repiten tanto?
Un modelo de lenguaje aprende de muchísimo texto y luego se ajusta con premios: personas y sistemas de puntuación valoran sus respuestas y el modelo da más de lo premiado. Si un giro gusta, se repite.
OpenAI contó el caso más claro el 29 de abril de 2026. Desde GPT-5.1, sus modelos llenaban cada vez más sus metáforas de duendes (goblins), gremlins y bichos parecidos, porque al entrenar la personalidad «Friki» de ChatGPT habían premiado sin querer esas metáforas, y el tic saltó a otras respuestas y al entrenamiento del modelo siguiente. Un estudio del congreso COLING 2025 sobre el abuso de delve («ahondar») apunta en la misma dirección, con prudencia: el ajuste con opiniones humanas podría influir, pero su experimento no fue concluyente y la opacidad de las empresas impide confirmarlo.
Anthropic presentó Opus 5.5 como más natural y, en su guía para Claude Fable 5.1, da a los programadores una instrucción contra la prosa amanerada, y OpenAI prometió con GPT-6 Sol y Luna menos giros raros. Caen las muletillas famosas y llegan otras. Entre las dos últimas versiones de cada familia, del 55 % al 72 % de las muletillas son exclusivas de una. Greg Druck, director de IA de Graphite, sospecha en TechCrunch que los laboratorios controlan estos detalles «menos de lo que cabría esperar».
¿Vale todo esto en español?
El estudio no mide nada en español, así que sus cifras no se pueden trasladar. Sí parecen extrapolables los moldes, que existen igual en nuestro idioma: «no es solo un X, es un Y», «esto importa porque…», «en esta guía completa…», el «Además,» al empezar frase y las frases de longitud calcada. No lo son los multiplicadores, las palabras concretas (dependable puede ser «fiable», «de confianza»…) ni la raya.
El trabajo serio más cercano es AuTexTification, una competición científica de 2023 organizada por la oficina en Valencia de la empresa alemana Symanto y la Universitat Politècnica de València, con más de 160.000 textos en inglés y español. El mejor sistema, de la Universitat Pompeu Fabra, sacó 80,9 puntos sobre 100 en inglés y 70,8 en español, donde 50 es tirar una moneda, y la mayoría de las cinco personas que probaron a ojo quedaron cerca del azar. Eso sí, con modelos de la época de GPT-3.
Además, las muletillas se contagian. Un equipo del Instituto Max Planck para el Desarrollo Humano analizó más de 700.000 horas de pódcast, en un trabajo prepublicado en arXiv: palabras típicas de ChatGPT como delve ganaron terreno al hablar, y en un experimento bastó una charla corta con un chatbot para que la gente adoptara sus palabras.
Los detectores tampoco son una prueba
¿Y un detector automático? OpenAI lanzó el suyo el 31 de enero de 2023. Reconocía el 26 % de los textos de IA, marcaba como artificiales el 9 % de los humanos y fallaba más fuera del inglés. Lo retiró el 20 de julio de ese año por su baja precisión.
Los errores no caen al azar. En un estudio de la Universidad de Stanford publicado en Patterns en julio de 2023, siete detectores marcaron como IA, de media, el 61 % de 91 redacciones de inglés escritas por personas no nativas. Con alumnos estadounidenses acertaron casi siempre: un vocabulario sencillo es previsible, como el de una máquina. Otro equipo probó 14 herramientas ese año, Turnitin incluida, y ninguna cazó todos los textos de IA retocados a mano o parafraseados.
Los de ahora fallan menos, al menos en algunas pruebas. En mayo de 2026, Graphite probó tres detectores comerciales (Pangram, Copyleaks y GPTZero) con 15.700 artículos humanos anteriores a ChatGPT, y marcaron por error entre el 1,4 % y el 1,8 %. Pero solo midió artículos en inglés y textos de IA sin retocar.
Turnitin, muy usado en universidades, admite en su guía, actualizada el 26 de agosto de 2026, que puede equivocarse y que no debe ser la única base para sancionar. Y su detector en español, a diferencia del inglés, no reconoce los textos parafraseados con herramientas.
Una pista, nunca una prueba
El propio Graphite no recomienda decidir por las muletillas quién ha escrito un texto, y propone un detector, con los límites que acabas de ver. Según quién seas:
- Si eres estudiante: escribe en un editor que guarde el historial de versiones y conserva tus borradores. Si te acusan, pregunta qué pruebas hay. Explicar cómo hiciste el trabajo pesa más que un porcentaje.
- Si eres profesor: ni diez muletillas ni un detector prueban nada. Úsalos para abrir una conversación: pregunta por el trabajo, pide los borradores y compáralo con lo que escribe en clase. Y cuidado con quien escribe en una lengua que no es la suya, a quien más señalaban por error en el estudio de Stanford.
- Si eres lector: fíjate en lo que hace flojo un texto, lo firme quien lo firme: frases que suenan bien y no dicen nada, ningún dato comprobable, ninguna fuente.
Tu compañero puede haber escrito con una IA ese correo que chirriaba. También puede que lea tanto texto de ChatGPT que ya escriba así, o que siempre haya escrito de esa manera. Como las muletillas no te van a sacar de dudas, lo más rápido sigue siendo preguntarle.
Fuentes
- Graphite: AI Tells: Opus 5.5 Update (1 de octubre de 2026), AI Tells (16 de septiembre de 2026) y AI Now Writes as Many Online Articles as Humans (mayo de 2026), en inglés, con sus datos descargables.
- TechCrunch, Russell Brandom: Opus 5.5 loves to tell you «this matters» (and other AI writing tells), 1 de octubre de 2026 (en inglés).
- Anthropic: presentación de Claude Opus 5.5 (22 de septiembre de 2026) y guía de instrucciones para Claude Fable 5.1 (en inglés).
- OpenAI: De dónde salieron los goblins (29 de abril de 2026), Presentamos GPT-6 Sol y Luna (22 de septiembre de 2026) y Nuevo clasificador de IA para detectar textos generados por IA (31 de enero de 2023, con la nota de su retirada).
- Google: Introducing Gemini 4 Argon (30 de septiembre de 2026), y TechCrunch: OpenAI launches GPT-6.1 Sol (29 de septiembre de 2026), en inglés.
- Juzek y Ward: Why Does ChatGPT «Delve» So Much?, COLING 2025 (en inglés).
- Yakura y otros (Instituto Max Planck para el Desarrollo Humano): Empirical evidence of Large Language Model’s influence on human spoken communication, versión de julio de 2026 (en inglés).
- Liang y otros (Universidad de Stanford): GPT detectors are biased against non-native English writers, Patterns, julio de 2023 (en inglés).
- Weber-Wulff y otros: Testing of detection tools for AI-generated text, International Journal for Educational Integrity, diciembre de 2023 (en inglés).
- Sarvazyan y otros (Symanto y Universitat Politècnica de València): Overview of AuTexTification at IberLEF 2023, y Przybyła y otros (Universitat Pompeu Fabra): el sistema ganador (en inglés).
- Turnitin: Using the AI Writing Report, actualizada el 26 de agosto de 2026 (en inglés).
- RAE: «raya», en el Diccionario panhispánico de dudas.
- Gráfico: elaboración propia con los datos descargables de Graphite.
